
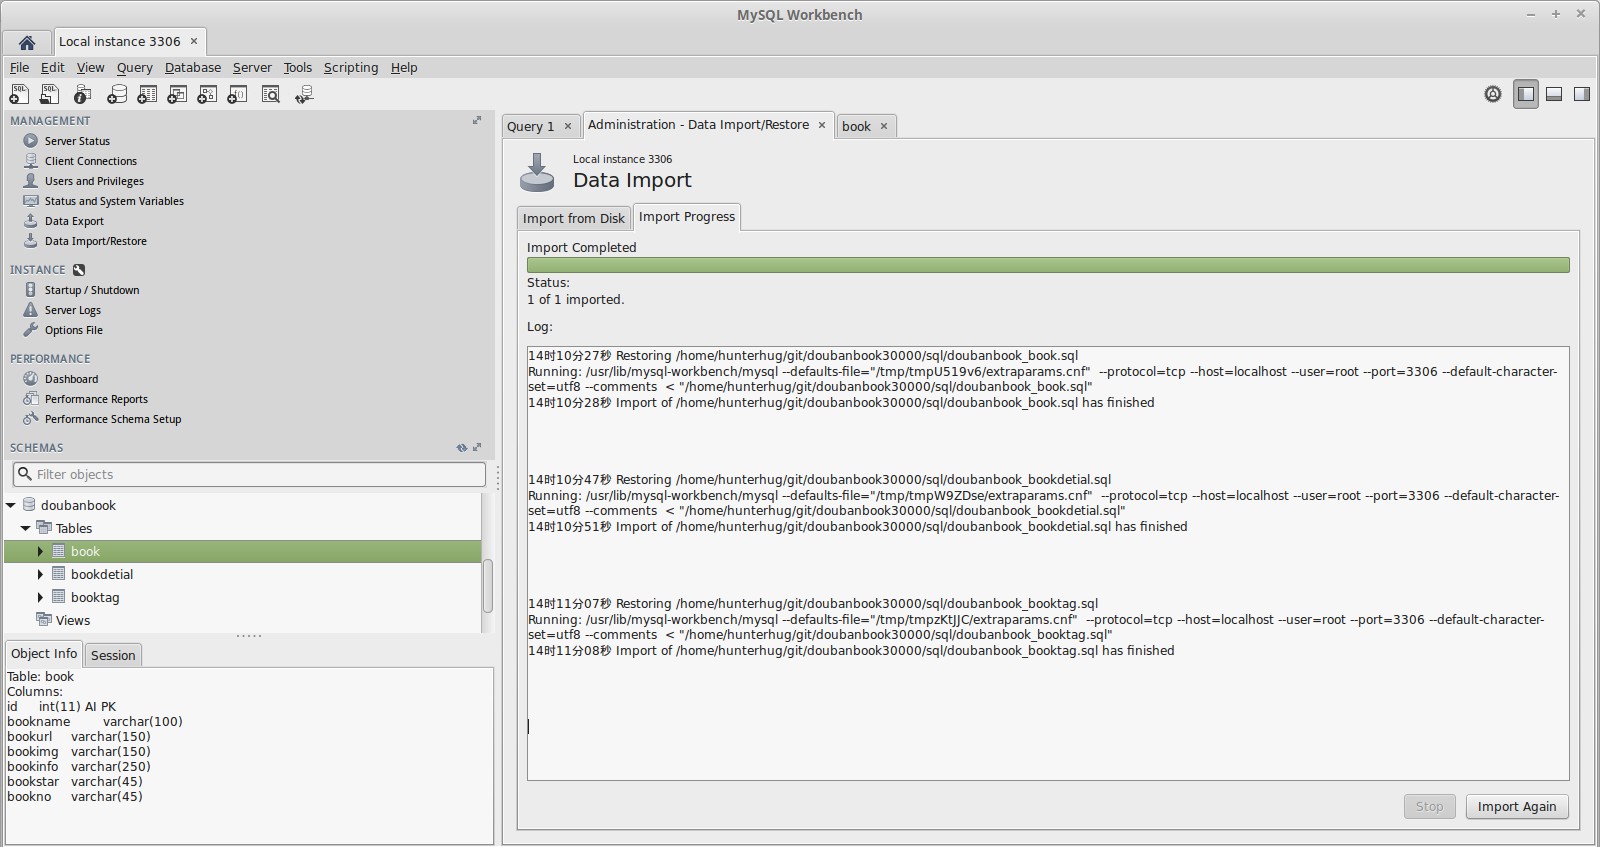
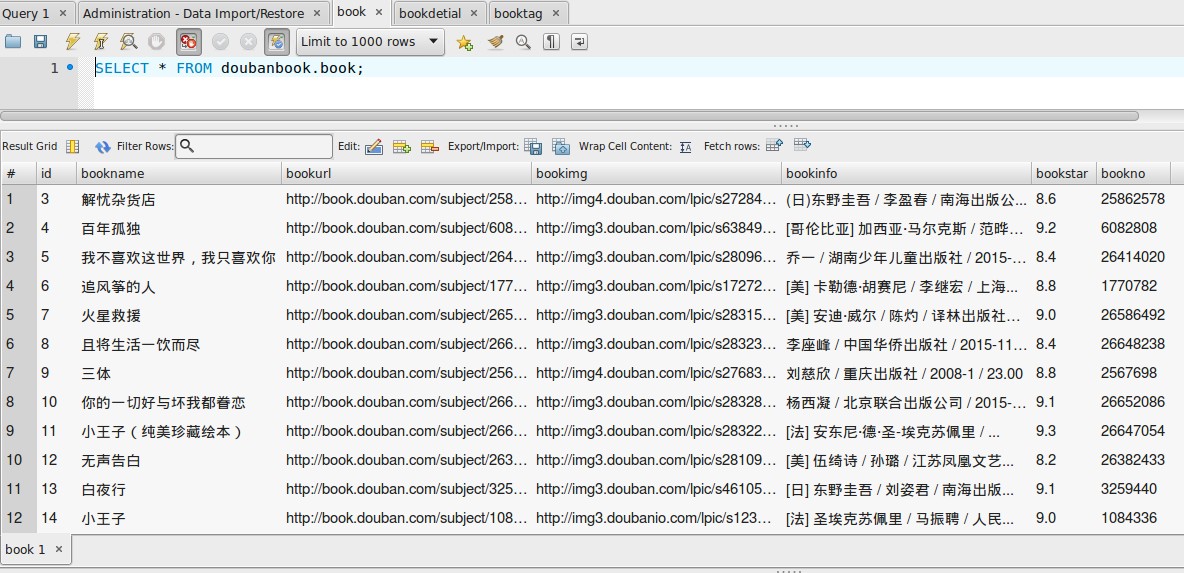
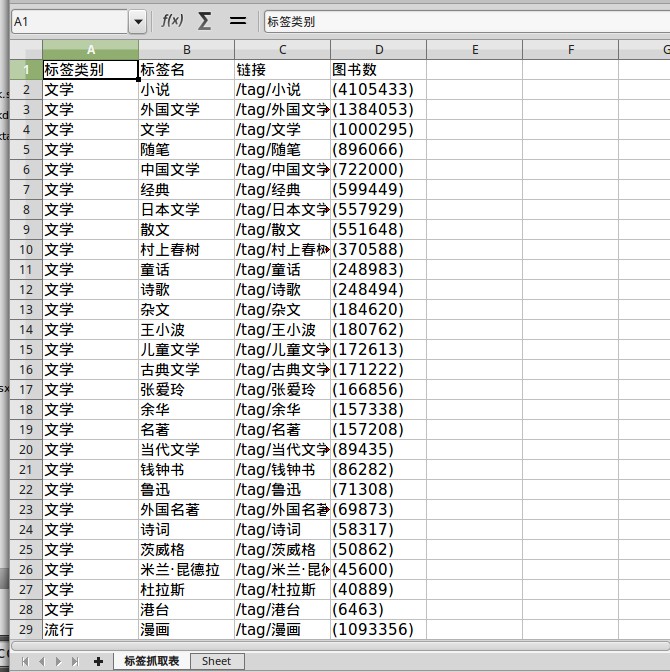
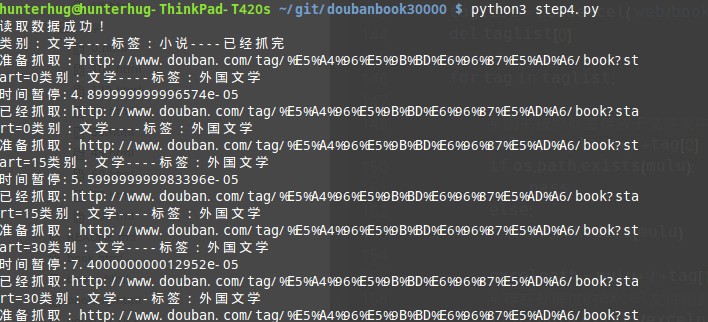
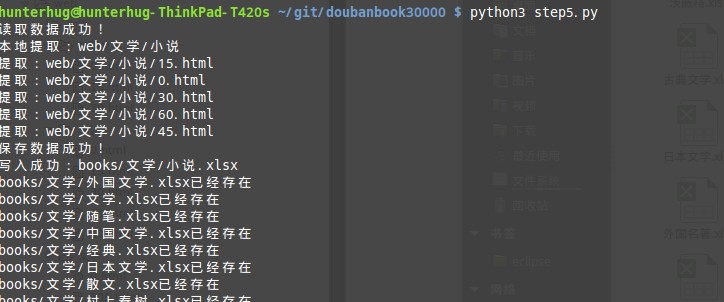
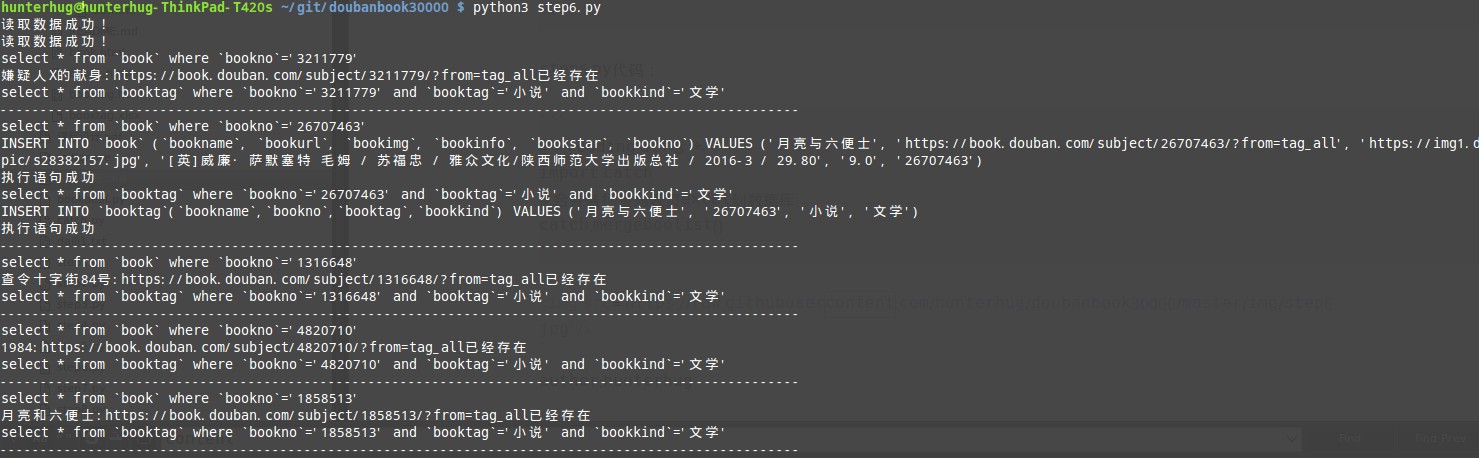
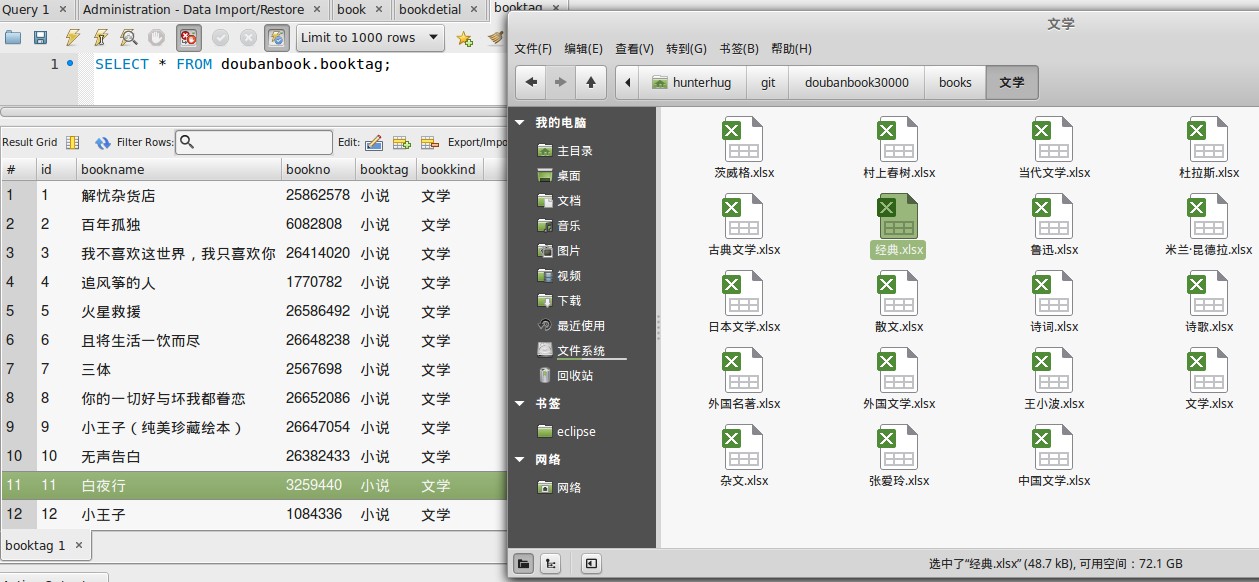
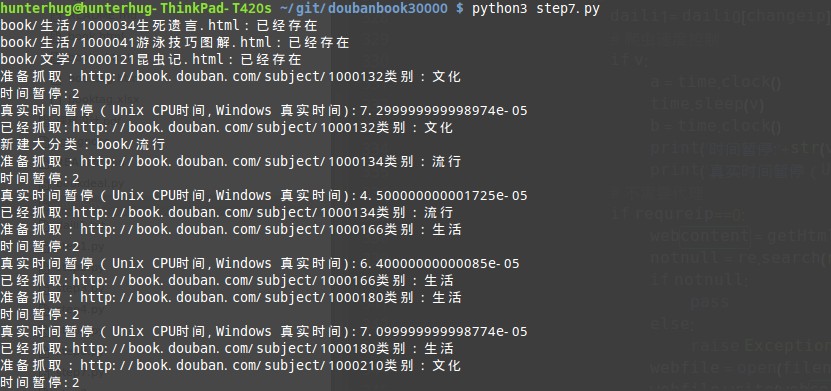
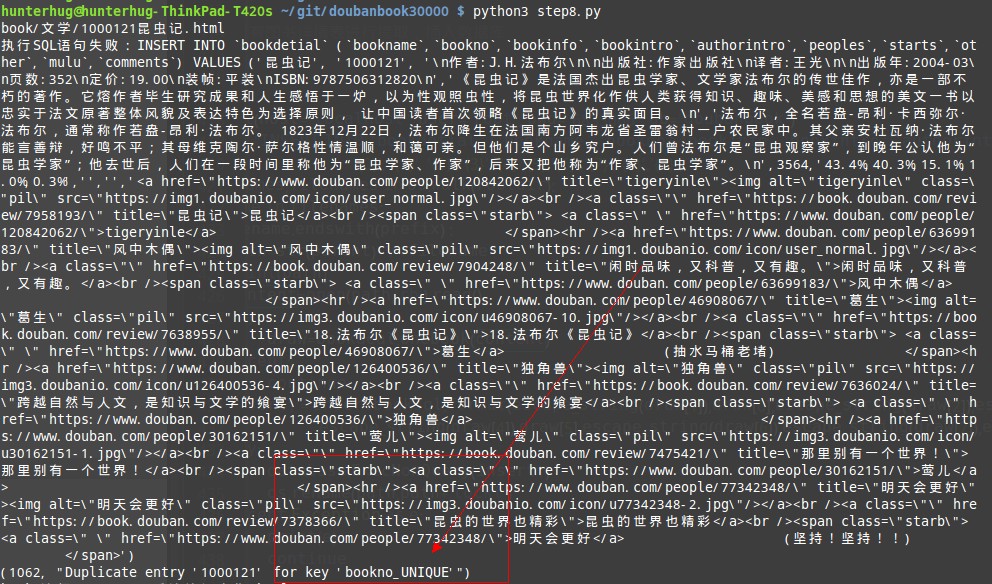
说明 爬虫程序运行请参考PDF,抓取豆瓣的大部分图书包括抓取分类标签页,列表页,详情页并保存进数据库 A project for catch the book of 豆瓣website in china. please see the code source BUG 2016.7.15修复标签页首页豆瓣改版,以及step8.py的数据库插入错误 及 Excel库函数API变化 目录结构 本爬虫程序目录如下: ----book 抓取的图书详情页 ----文学 大分类 ----1000121昆虫记.html 标号+标题 ----文化 ----生活 ----流行 ----经管 ----books 提取的图书列表页 ----文学 大分类 ----茨威格.xlsx 标签 ----文化 ----生活 ----流行 ----经管 ----data 提取的数据库文件 ----doubanbook.book.sql 图书基本信息 ----doubanbook_booktag.sql 图书标签信息 ----image 抓取的图片 ----img 实例图片 ----web 抓取的图书列表页 ----文学 大分类 ----茨威格 标签 ----0.html 列表页 ----1.html ----文化 ----生活 ----流行 ----经管 ----book.html 测试的图书详情页 ----books.html 测试的图书列表页 ----booktag.html 测试图书标签页 ----booktag.xlsx 提取的图书标签页 ----tool 抓取工具 How to use? Install python3.4 or another python3 version Just install some python library if run was wrong run step1.py run step2.py and so on 如何使用 step1.py:数据库初始化 python step1.py step1.py代码: # -*- coding:utf-8 -*- import tool.mysql # 新建数据库 result = tool.mysql.initdoubanbook() print(result) 需先更改tool/mysql.py数据库用户名和密码 def init(): return Mysql(host="localhost", user="root", pwd="passwd", db="doubanbook") def initdoubanbook(): mysql = pymysql.connect(host="localhost", user="root", passwd="passwd", charset="utf8") step2.py抓取页面进行测试 python step2.py step2.py代码: # -*- coding:utf-8 -*- from tool.gethtml import getHtml import bookdeal # 抓取分类标签页 tag =getHtml(http://book.douban.com/tag/) file = open(web/booktag.html,wb) file.write(tag.encode()) file.close() # 抓取列表页方便测试 tag1 = getHtml("http://www.douban.com/tag/%E5%B0%8F%E8%AF%B4/book") file1 = open(web/books.html,wb) file1.write(tag1.encode()) file1.close() # 抓取图书页方便测试 tag3 = getHtml("http://book.douban.com/subject/25862578/?from=tag_all") file2 = open(web/book.html,wb) file2.write(tag3.encode()) file2.close() print("成功") 测试请直接运行bookdeal.py step3:抽取分类标签页存入Excel方便匹配分类 python step3.py step3.py代码: # -*- coding:utf-8 -*- import bookdeal # 提取标签页到excel bookdeal.testbooktag() step4.py抓取图书列表页 python step4.py step4.py代码: # -*- coding:utf-8 -*- import catch # 抓取各标签列表页 """ 输入参数为: requireip 是否使用代理,默认否,代理文件在tool文件夹下daili.txt:http://www.youdaili.net/ v 是否限制爬虫速度,默认否,时间为1秒仿人工 lockprefix 文件加锁后缀 """ catch.catchbooklist(0,2,html) step5.py提取图书列表页到Excel python step5.py step5.py代码: # -*- coding:utf-8 -*- import catch # 提取各标签列表页到excel catch.dealbooklist() step6.py根据图书列表页Excel,提取分类,写入数据库 python step6.py step6.py代码: # -*- coding:utf-8 -*- import catch # 合并各标签列表页excel到数据库 catch.mergeboolist() 需更改catch.py的数据库配置 database = Mysql(host="localhost", user="root", pwd="6833066", db="doubanbook") step7.py根据图书列表页Excel,提取分类,写入数据库 python step7.py step7.py代码: # -*- coding:utf-8 -*- import catch # 抓取图书详情页 # 读取book表,读取booktag表,抓取图书网页拷贝多份到不同标签目录 def catchbook(requreip = 0, v=0,startbook=0): """ 输入参数为: 是否使用代理,默认否 是否限制爬虫速度,默认否,时间为1秒仿人工 startbook = 0 查询起始位置,如果处理过程失败,可以抽取数据库第startbook条数据之后进行爬取 """ catch.catchbook(0,0,34800)#1900 step8.py根据图书详情页,抽取数据写入数据库 python step8.py step8.py代码: # -*- coding:utf-8 -*- import catch # 处理提取图书详情页 catch.dealbook() author:hunterhug
Python:豆瓣图书巨大只爬虫.30000本书已抓,抓取豆瓣图书便签分类页,根据分类标签抓取标签下图书列表,根据图书列表抓取图书详情介绍,包括星数,评分,书籍简介,书籍目录,书籍评论等,保存在Excel和数据库中,抓取时间2个星期,可以根据数据进行分析,描绘书籍等级,分布情况等,代码层次分明,可观摩学习.正在制作网站,请移步仓库doubanbookweb
3997
来源:
Licence:
联系:
分类:
平台:
环境:
大小:
更新:
标签:
免费下载
×


温馨提示
请用电脑打开本网页,即可以免费获取你想要的了。
